Oak Ridge abrió a los científicos el supercomputador Lux, con 4032 GPU de AMD, y destinará la mitad de su tiempo a la Genesis Mission.
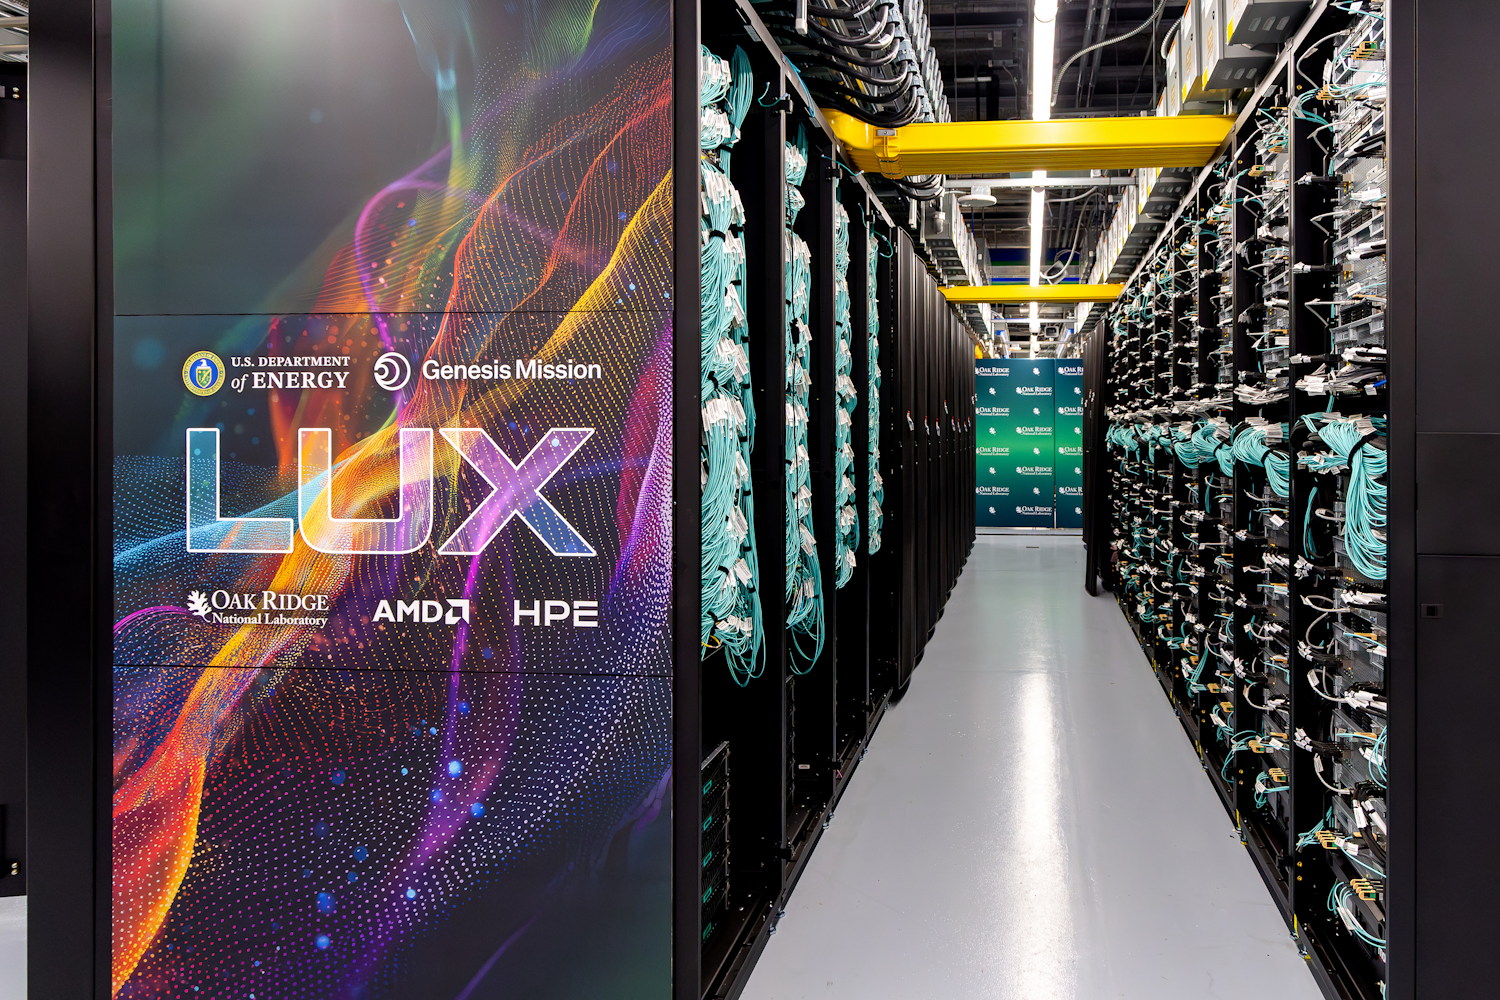
El Laboratorio Nacional de Oak Ridge abrió el acceso al supercomputador Lux el 16 de noviembre, durante la conferencia de supercomputación SC26 en Chicago. HPE y AMD construyeron el sistema con 4032 GPU Instinct MI355X distribuidas en 504 nodos para entrenar modelos de IA y ejecutar simulaciones científicas.
Oak Ridge reservará cerca de la mitad del tiempo de cómputo para la Genesis Mission, el programa del Departamento de Energía de Estados Unidos que combina IA, simulaciones y datos experimentales. Uno de sus primeros proyectos, FADO, usará agentes de IA para evaluar cómo la ubicación de los accesos de mantenimiento de un reactor de fusión influye en su respuesta térmica y en la posibilidad de repararlo con brazos robóticos.
Los programas que simulan una planta piloto de fusión permiten estudiar su respuesta térmica, el transporte de neutrones y los sistemas de control antes de construirla. Preparar esos cálculos exige la intervención de varios especialistas, y un modelo centrado en el funcionamiento del reactor puede dejar para más adelante preguntas sobre su construcción, inspección o mantenimiento.
El proyecto Fusion Agentic Design Orchestrator (FADO), dirigido por Katarzyna Borowiec en Oak Ridge con el Instituto de Tecnología de Georgia y Microsoft como socios, desarrollará un entorno virtual en el que varios agentes de IA coordinen la preparación y ejecución de esas simulaciones. Oak Ridge identifica cinco funciones en su diseño: una para la geometría del dispositivo, otra para el modelado y la simulación, una tercera para la robótica, una cuarta para los datos y el conocimiento técnico, y una quinta para evaluar las condiciones de operación y mantenimiento.
La primera fase tiene una prueba definida. El equipo evaluará cómo cambian la respuesta térmica y el comportamiento de los neutrones al modificar la división del reactor en segmentos y la posición de sus puertos de mantenimiento. Sobre esas mismas configuraciones estudiará la disponibilidad de la planta y la posibilidad de intervenirla mediante robots.
Así, dos diseños que parezcan aceptables desde el punto de vista térmico pueden distinguirse al considerar el acceso para mantenimiento. El objetivo de la primera fase es demostrar que los agentes pueden coordinar ese análisis de ingeniería. La integración de una versión preparada para uso regular en la Genesis Mission corresponde a una segunda etapa.
En Pipit, los agentes tendrán una función diferente. El grupo que dirige Stephen DeWitt en Oak Ridge, junto con la Universidad de Texas en Austin y GE Vernova, partirá de prototipos de aprendizaje automático para desarrollar modelos especializados en ingeniería de materiales y fabricación avanzada. Una de las aplicaciones que identifica el laboratorio es el estudio de las microestructuras de aleaciones producidas mediante impresión 3D.
El trabajo que separa un prototipo de un modelo que otros investigadores puedan utilizar incluye generar y seleccionar datos, construir el modelo, entrenarlo y desplegarlo en un sistema de cómputo de gran escala. Pipit usará agentes que escriben código para convertir los prototipos en programas que conecten esas etapas. El equipo prevé compartir los modelos resultantes, los datos generados y las pruebas con que evaluará su desempeño.
El tercer proyecto asignado al supercomputador Lux aborda una decisión que depende tanto del volumen de agua como de su temperatura. Una central hidroeléctrica necesita anticipar cuánto caudal llegará a sus embalses, mientras que una termoeléctrica requiere suficiente agua de refrigeración y debe operar dentro de límites térmicos. Oak Ridge y el Instituto de Tecnología de Georgia estudiarán ambas condiciones en la región que atiende la Tennessee Valley Authority.
El equipo de Dali Wang combinará observaciones del sistema terrestre con simulaciones de E3SM, el modelo climático del Departamento de Energía. Un modelo de IA basado en ORBIT/LANDSIM incorporará tanto las condiciones locales de la superficie como las relaciones climáticas de mayor escala para pronosticar disponibilidad de agua, caudales y temperaturas con horizontes de semanas a años.
Los investigadores compararán sus pronósticos con métodos de referencia y medirán cómo cambia su precisión a medida que se aleja la fecha pronosticada. Para los operadores de una central, conocer la probabilidad de que el río cruce un umbral de temperatura o caudal puede servir para programar un mantenimiento, decidir cuánta agua reservar o anticipar una restricción de refrigeración.
HPE construyó Lux con servidores ProLiant Compute XD685 de refrigeración líquida directa. Cada nodo contiene dos procesadores AMD EPYC 9575F de 64 núcleos y 3 TB de memoria DDR5 compartida por las CPU. Los 504 nodos reúnen así 1008 procesadores y 64512 núcleos de CPU, además de los aceleradores que ejecutan los cálculos en paralelo.
Cada nodo incorpora ocho GPU AMD Instinct MI355X. Una MI355X contiene ocho chips de cómputo de arquitectura CDNA 4, con 32 unidades de cómputo activas por chip y 256 por acelerador. Aunque un servidor contiene 64 de estos chips, el software presenta al investigador ocho GPU, cada una con su propio espacio de memoria.
La memoria que alimenta directamente a cada acelerador es HBM3E de 288 GB, con un ancho de banda máximo de 8 TB/s por GPU. Los ocho aceleradores de un servidor suman 2304 GB de HBM3E, físicamente distribuidos entre ellos. Cuando un modelo necesita más de los 288 GB de una GPU, el programa debe repartir sus datos y el cálculo entre varios aceleradores.
Dentro del servidor, las ocho MI355X se comunican mediante enlaces directos Infinity Fabric. Cuando el cálculo se extiende a otros nodos, entra en juego una red Ethernet con una interfaz AMD Pensando Pollara de 400 Gb/s por GPU. Los conmutadores HPE Juniper QFX admiten enlaces de hasta 800 Gb/s y distribuyen el tráfico para reducir la congestión cuando numerosos aceleradores intercambian datos al mismo tiempo.
Oak Ridge divide el equipo en dos particiones cuyo tamaño puede ajustar según la demanda. En la primera, Slurm recibe trabajos por lotes y reserva los recursos durante su ejecución. Un investigador puede preparar una simulación, indicar cuántos nodos y GPU necesita y dejar el cálculo en cola hasta que el sistema pueda atenderlo.
La segunda partición utiliza Kubernetes para administrar aplicaciones en contenedores. En Lux, una aplicación puede mantener servicios en CPU y solicitar GPU para trabajadores con una duración definida. La guía de Oak Ridge fija un máximo de 48 horas para estos trabajos y permite solicitar hasta ocho GPU en un mismo pod, la unidad con la que Kubernetes agrupa los contenedores que deben ejecutarse juntos.
Para leer y escribir datos cerca de donde se ejecuta el cálculo, cada servidor incorpora ocho SSD NVMe Kioxia CM7 de 3.2 TB, equivalentes a 25.6 TB nominales por nodo. Los investigadores pueden usar estas unidades como almacenamiento temporal durante un trabajo o escribir directamente en Orion, el sistema de archivos paralelo del centro, que dispone de 679 PB utilizables.
Orion permite repartir una investigación entre Lux y Frontier, el supercomputador de Oak Ridge que en 2022 superó el exaflop en doble precisión. Un grupo con tiempo asignado en ambas máquinas puede ejecutar una simulación en Frontier, guardar los resultados en Orion y entrenar con esos datos un modelo en Lux. Los dos equipos acceden al mismo sistema de archivos durante etapas distintas del trabajo.
El supercomputador Lux debutó en el puesto 14 del TOP500 de noviembre de 2026, con 220.79 petaflops en High Performance Linpack (HPL). La prueba resuelve un sistema denso de ecuaciones lineales en doble precisión. Frente al máximo teórico de 323.90 petaflops que registra TOP500 para la máquina, Lux sostuvo cerca del 68.2% durante esta medición.
La diferencia entre HPL y HPCG muestra cuánto influye el tipo de problema sobre una misma máquina. En HPL, los datos forman una matriz densa y el cálculo sigue un patrón regular. HPCG trabaja con matrices dispersas, en las que gran parte de los elementos son cero, y exige acceder a la memoria e intercambiar datos de otra manera.
Los 40 exaflops corresponden a otra operación. Oak Ridge atribuye esa cifra a la inferencia en FP4, donde se usan cuatro bits para representar un número, y especifica 20 exaflops en FP8 para entrenamiento. El tiempo que tardará un modelo científico en producir un pronóstico o completar una simulación dependerá también de los datos que mueva y de la precisión que exijan sus cálculos.
El Departamento de Energía y AMD anunciaron el supercomputador Lux en octubre de 2025 junto con Discovery, cuyo arribo a Oak Ridge está previsto para 2028. Los dos sistemas tienen funciones distintas. Lux añade capacidad dedicada a investigaciones con IA y puede trabajar con los datos de Frontier, mientras que Discovery está previsto como sucesor de Frontier para una comunidad más amplia de usuarios de simulación y supercomputación.
El acuerdo contempla 3.5 millones de horas de nodo al año y reserva aproximadamente 1.75 millones para la Genesis Mission. AMD dispone de la otra mitad para desarrollo y pruebas, y puede asignar una parte a organizaciones públicas o privadas mediante acceso pagado. Una hora de nodo equivale a ocupar durante una hora uno de los servidores con sus dos CPU y sus ocho GPU.
Para los socios que contratan tiempo de cómputo, Oak Ridge fija un mínimo de 175000 horas de nodo por cada compromiso de seis meses. El centro ilustra qué significa esa asignación para un equipo de investigación: puede concentrarla en unos 18 días de trabajo con 400 nodos y 3200 GPU, o distribuirla durante el semestre para mantener cerca de 40 nodos en uso continuo.
Scott Atchley, director de tecnología del National Center for Computational Sciences, explica en el siguiente video por qué Oak Ridge destinó una máquina específica a estas investigaciones y cómo se reparten las funciones de Lux, Frontier y Discovery.