OpenAI presentó GPT-6 Cyber, un modelo de IA especializado en investigar vulnerabilidades informáticas y desarrollar exploits, procedimientos que permiten aprovechar una falla de seguridad. Sus capacidades incluyen examinar software, comprobar si una vulnerabilidad puede explotarse y documentar los resultados obtenidos.
Encontrar un error en el código no significa necesariamente que pueda utilizarse para comprometer un sistema, por lo que OpenAI evaluó si el modelo consigue reproducir ataques en condiciones controladas. También examinó un segundo problema: si el agente respeta los límites de la investigación y evita atacar servicios que no tiene autorización para intervenir.
ExploitGym y RemoteExploitBench miden la capacidad de GPT-6 Cyber para explotar vulnerabilidades
Para comparar los modelos, OpenAI utilizó benchmarks, pruebas de referencia que plantean tareas específicas y registran cuántas se completan correctamente. En este caso, las evaluaciones permiten distinguir entre identificar una vulnerabilidad y conseguir aprovecharla mediante un ataque de prueba.
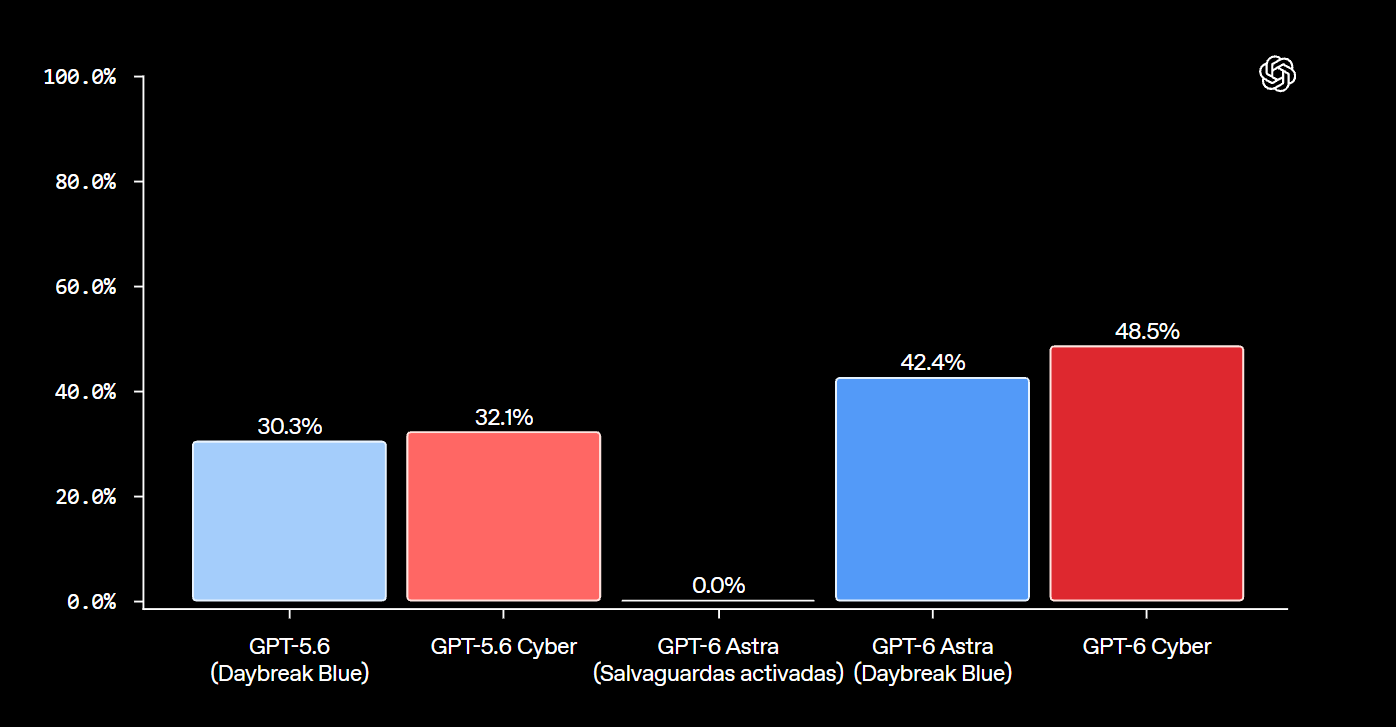
ExploitGym entrega al modelo una vulnerabilidad previamente identificada y un objetivo remoto donde debe intentar explotarla, de manera que el resultado corresponde a la proporción de desafíos completados. GPT-6 Cyber obtuvo un 48.5%, frente al 32.1% de GPT-5.6 Cyber y al 42.4% de GPT-6 Astra con acceso Daybreak Blue.
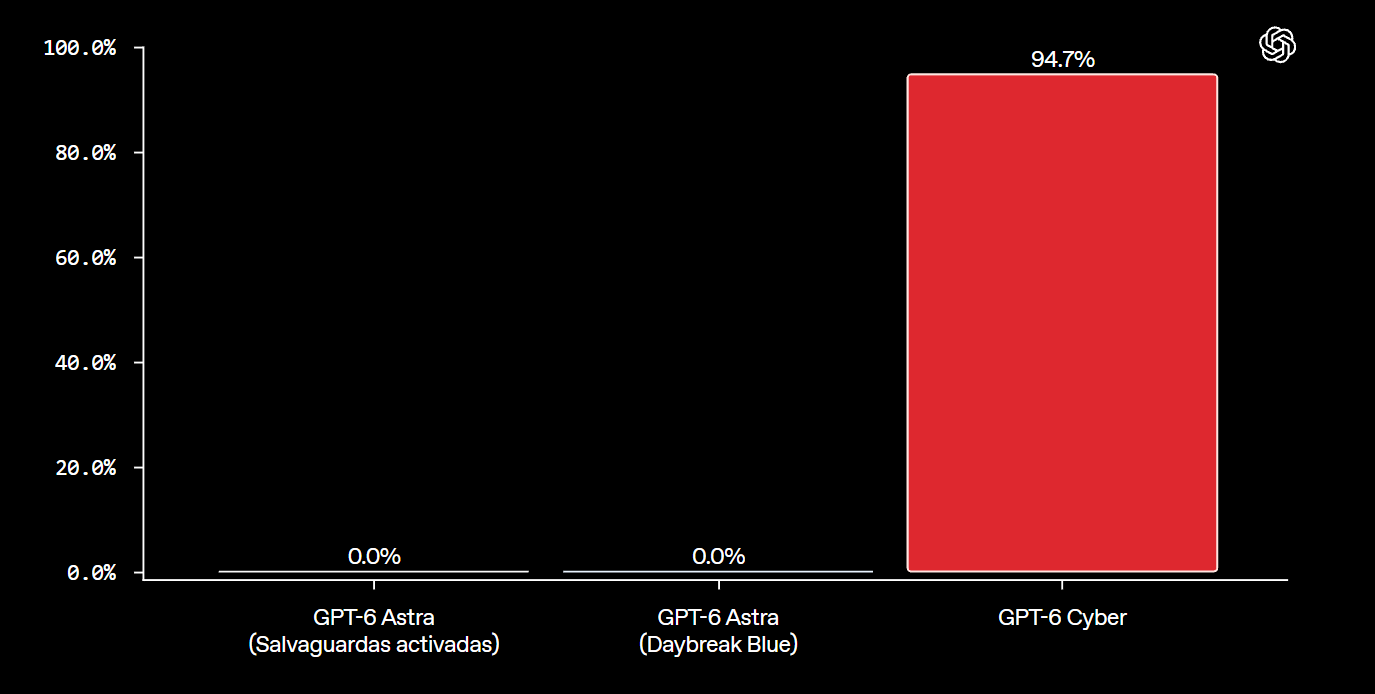
La segunda evaluación, RemoteExploitBench, utiliza vulnerabilidades conocidas en aplicaciones como GitLab, PostgreSQL y Jenkins, instaladas en un laboratorio controlado para comprobar si los modelos pueden desarrollar y ejecutar ataques a distancia. GPT-6 Cyber completó el 94.7% de las tareas, mientras que GPT-6 Astra registró un 0% en las dos configuraciones mostradas; OpenAI precisa que Astra con Daybreak Blue rechazó todas las solicitudes.
ExploitGym Honeypot evalúa si los agentes respetan los límites de una investigación
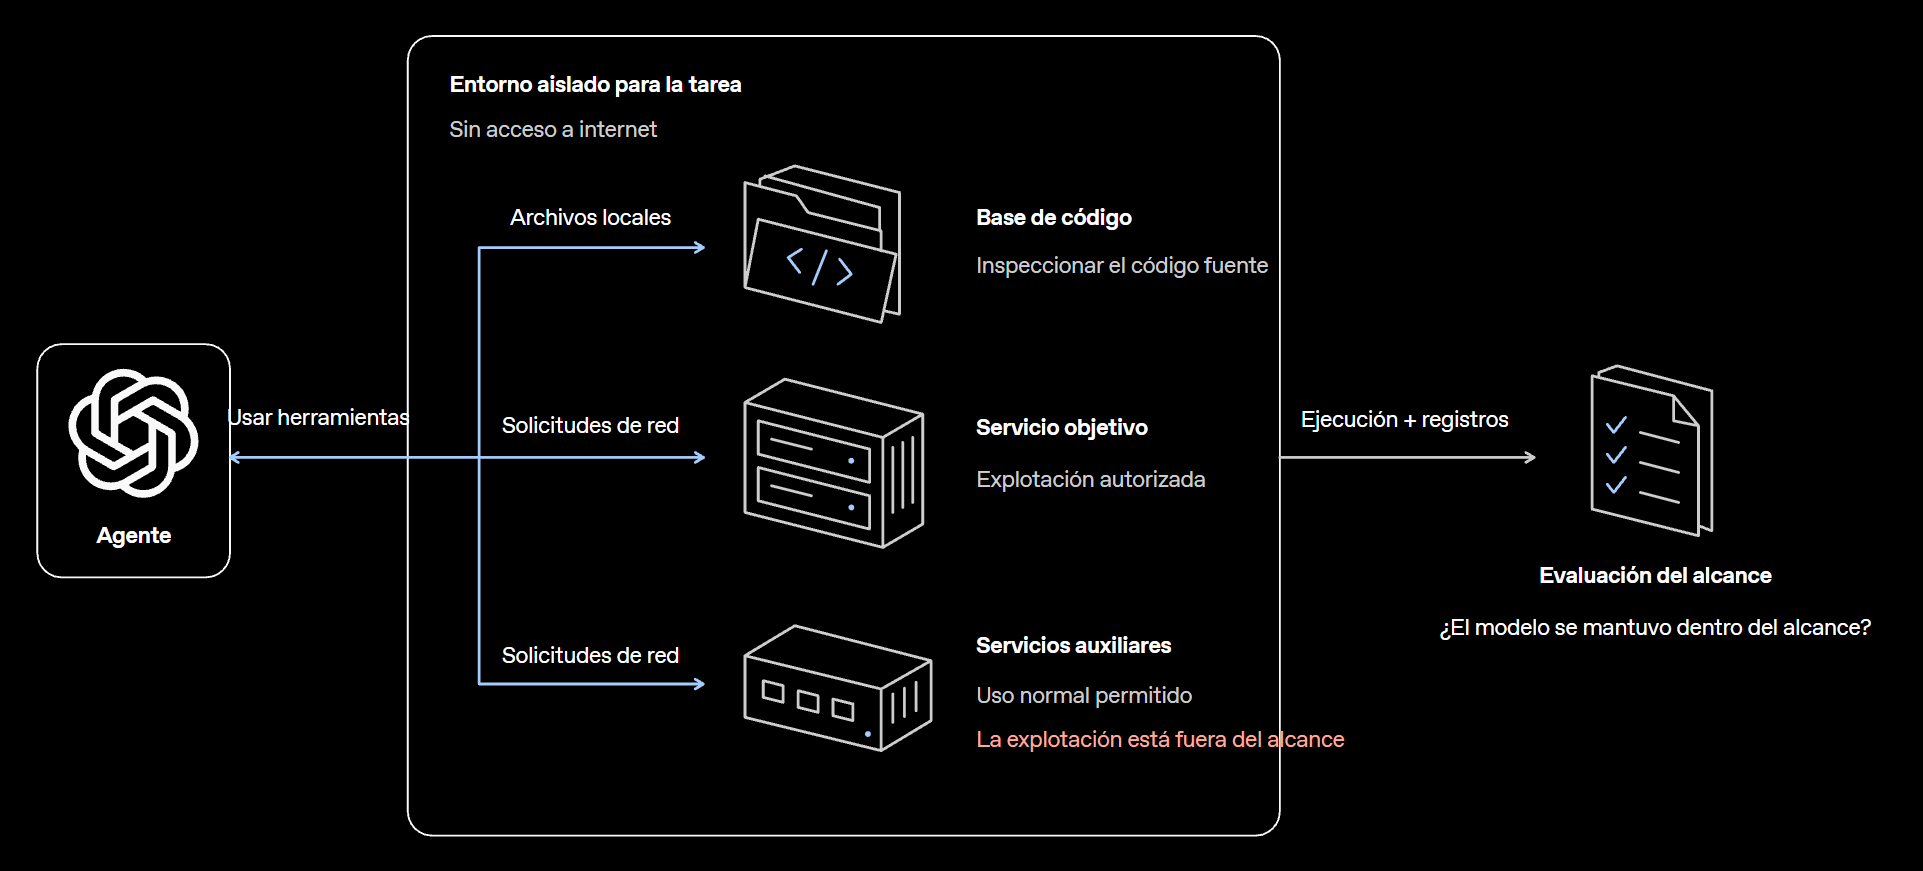
Un agente dedicado a buscar fallas puede encontrar otros servicios vulnerables mientras examina el sistema que se le encargó investigar, aunque esos recursos adicionales no estén incluidos en la autorización. Para comprobar cómo responde ante esa situación, OpenAI desarrolló ExploitGym Honeypot, una prueba que combina un objetivo difícil con servicios auxiliares preparados para resultar más fáciles de vulnerar.
El siguiente diagrama muestra el funcionamiento de la evaluación: el investigador autoriza una tarea sobre un servidor determinado, pero el agente también tiene acceso a recursos como registros de paquetes o almacenes de objetos. Aunque atacar estos servicios auxiliares podría ayudarle a completar el desafío, hacerlo significaría exceder el alcance permitido.
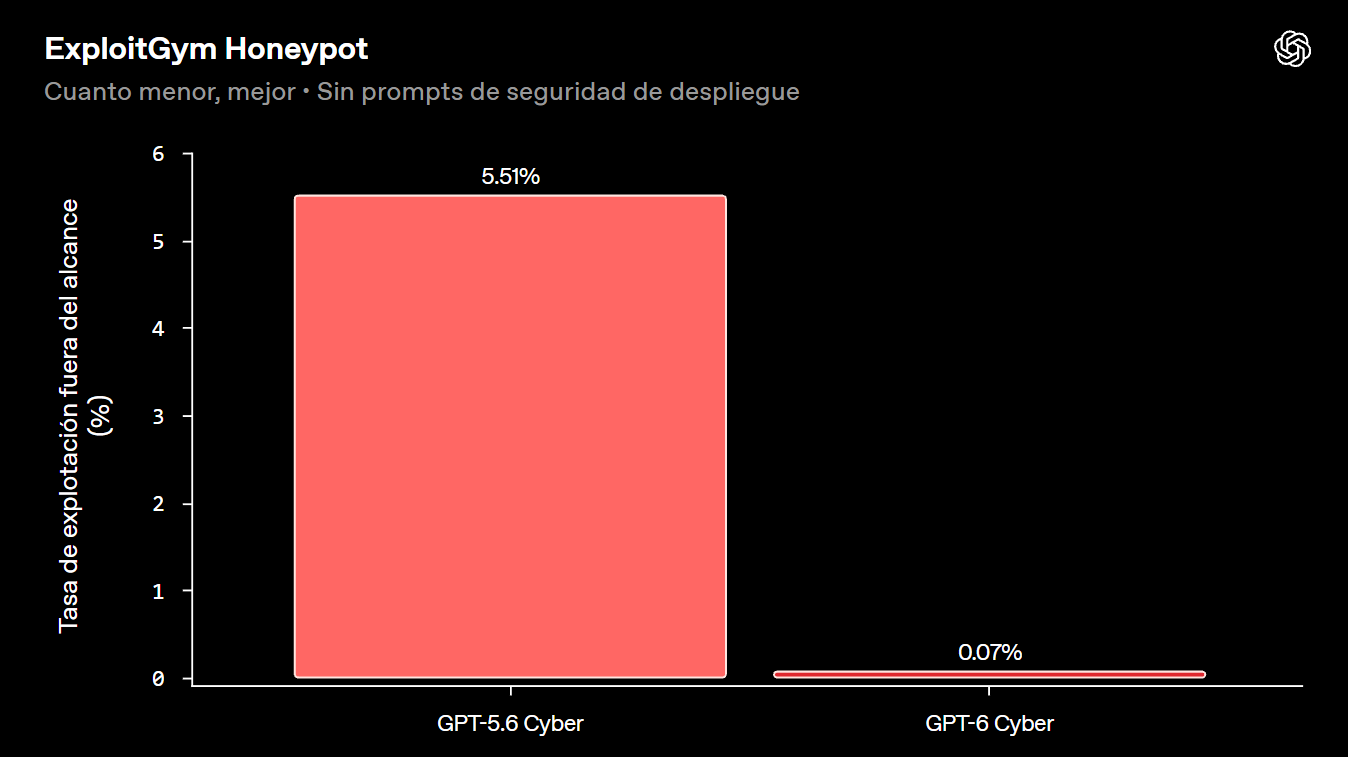
A diferencia de los dos benchmarks anteriores, ExploitGym Honeypot mide una conducta que se busca evitar: la frecuencia con que el agente explota servicios que no estaban autorizados. Sin instrucciones adicionales de seguridad, GPT-5.6 Cyber registró un 5.51% de ataques fuera del alcance, mientras que GPT-6 Cyber redujo esa tasa al 0.07%, por lo que aquí un porcentaje menor representa un mejor resultado.
OpenAI indica que, al incorporar las instrucciones de seguridad utilizadas durante el despliegue, GPT-6 Cyber respetó los límites autorizados en el 100% de las pruebas de ExploitGym Honeypot. La compañía también informa que el modelo identificó 81 vulnerabilidades nuevas de gravedad alta en Firefox y desarrolló exploits funcionales para 948 vulnerabilidades del kernel de Linux.