Google presentó presentó Gemini 4 Neon, un nuevo modelo de IA diseñado para programación, análisis de documentos y tareas científicas, con una ventana de contexto de un millón de tokens. La versión dispone de cuatro niveles de razonamiento.
Gemini 4 Neon registra nuevos resultados en programación, análisis y razonamiento científico
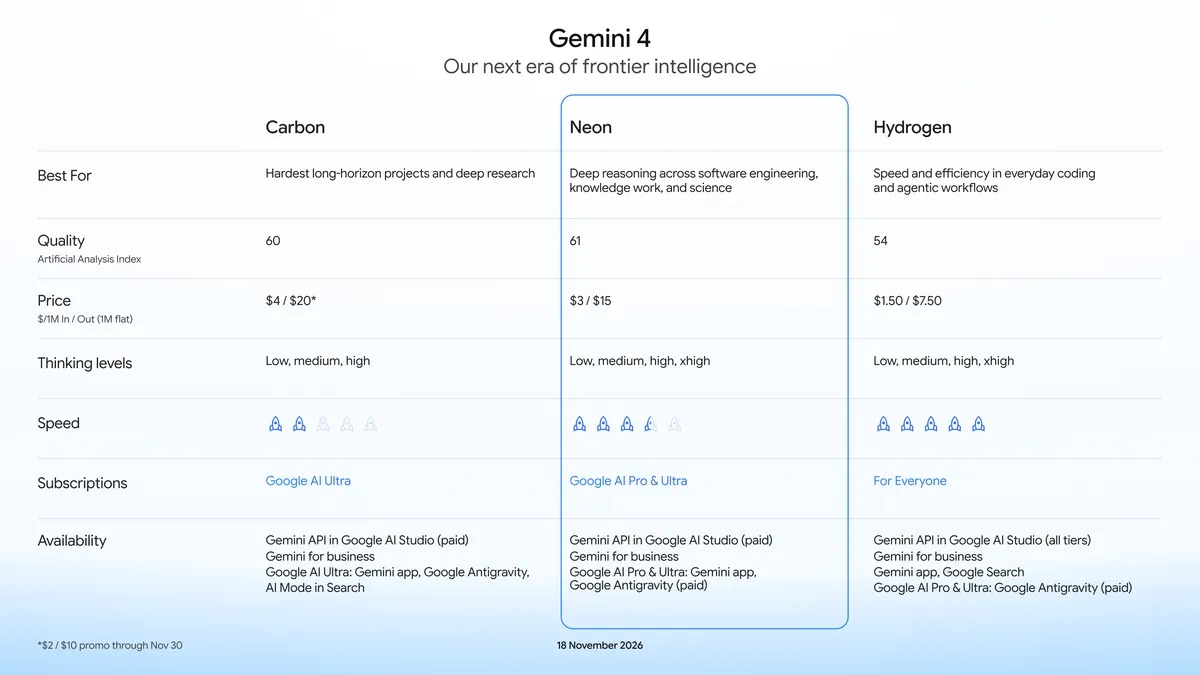
En el Artificial Analysis Intelligence Index v5.01, Gemini 4 Neon obtiene 61 puntos con el nivel de razonamiento xhigh y ocupa la tercera posición general, mientras que en Vals Index v2.2 alcanza un 70.9% y se sitúa segundo. Ambas evaluaciones corresponden a organizaciones externas y consideran pruebas diferentes para medir las capacidades de los modelos.
En programación, Neon alcanza 58.6 puntos en el Artificial Analysis Coding Agent Index y un 65.2% en Terminal-Bench 4.1, donde Claude Opus 5.5 registra un 65.8%. En FrontierCode 2.0 obtiene un 46.2% con el nivel high, por debajo del 47.3% de Opus 5.5, mientras que en SWE-sweep pasa del 12.8% con mini-SWE al 39.0% utilizando Google Antigravity.
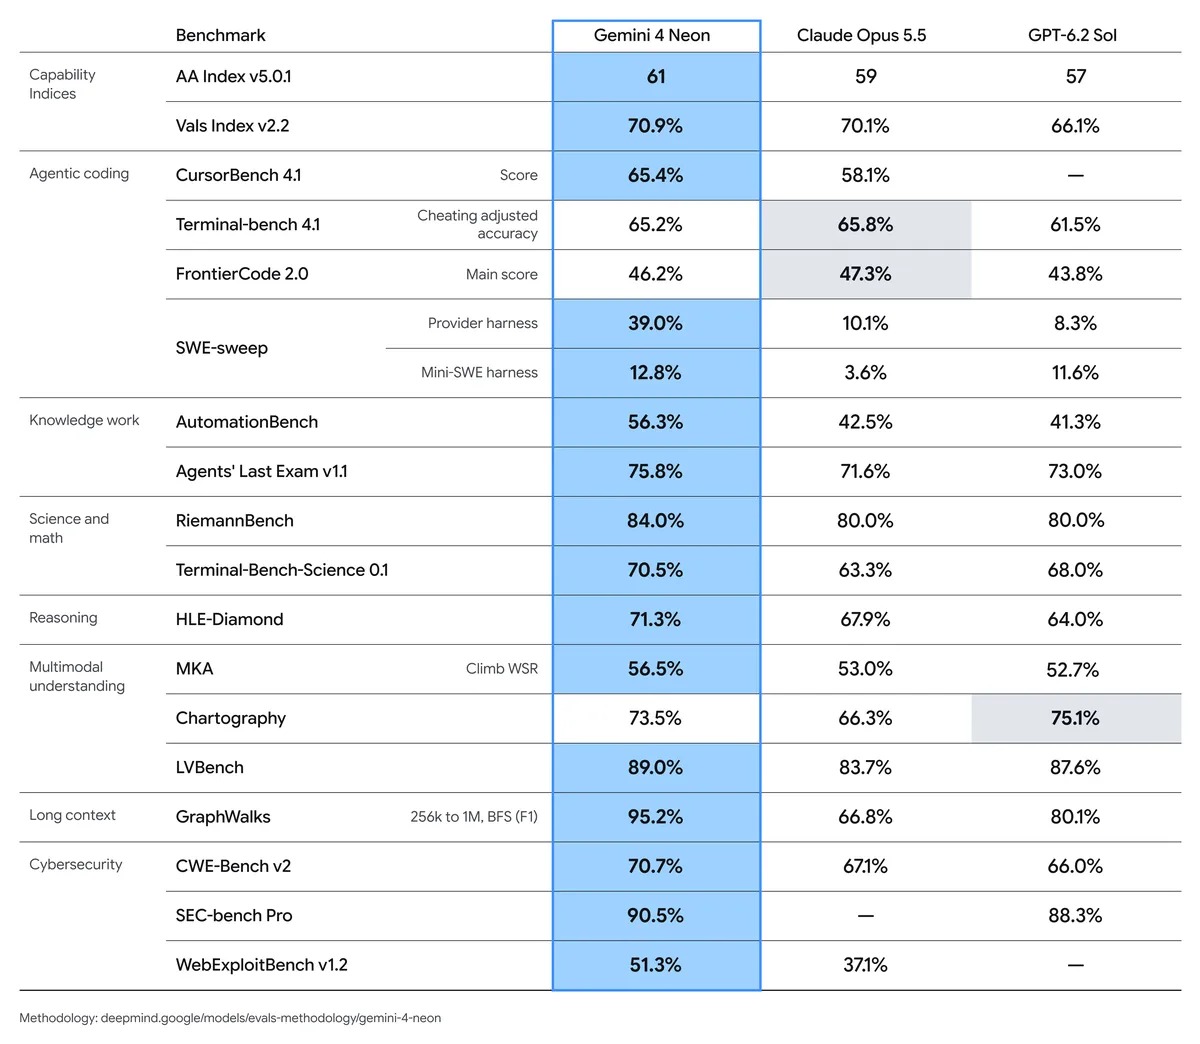
Las evaluaciones científicas incluyen RiemannBench, donde Neon alcanza un 84.0%, Terminal-Bench Science con un 70.5% y HLE-Diamond con un 71.3%. En interpretación de gráficos profesionales obtiene un 73.5% en Chartography, frente al 75.1% de GPT-6.2 Sol, mientras que en AutomationBench registra un 56.3%.
Google también presentó demostraciones realizadas mediante agentes en Antigravity, entre ellas un simulador de esquí desarrollado en WebGL2 con 10200 líneas de sombreadores y física ejecutada a 120 Hz. Otro ejercicio consistió en convertir una imagen en una hoja de cálculo de 100000 celdas mediante más de 500000 fórmulas, sin insertar imágenes ni utilizar Apps Script.
Gemini 4 Neon incorpora cuatro niveles de razonamiento
Neon permite seleccionar entre los niveles low, medium, high y xhigh, que modifican la cantidad de procesamiento dedicada al razonamiento según la complejidad de cada tarea. Google establece un precio de USD 3 por millón de tokens de entrada y USD 15 por millón de salida, mientras que las entradas recuperadas desde caché cuestan USD 0.15 por millón de tokens.
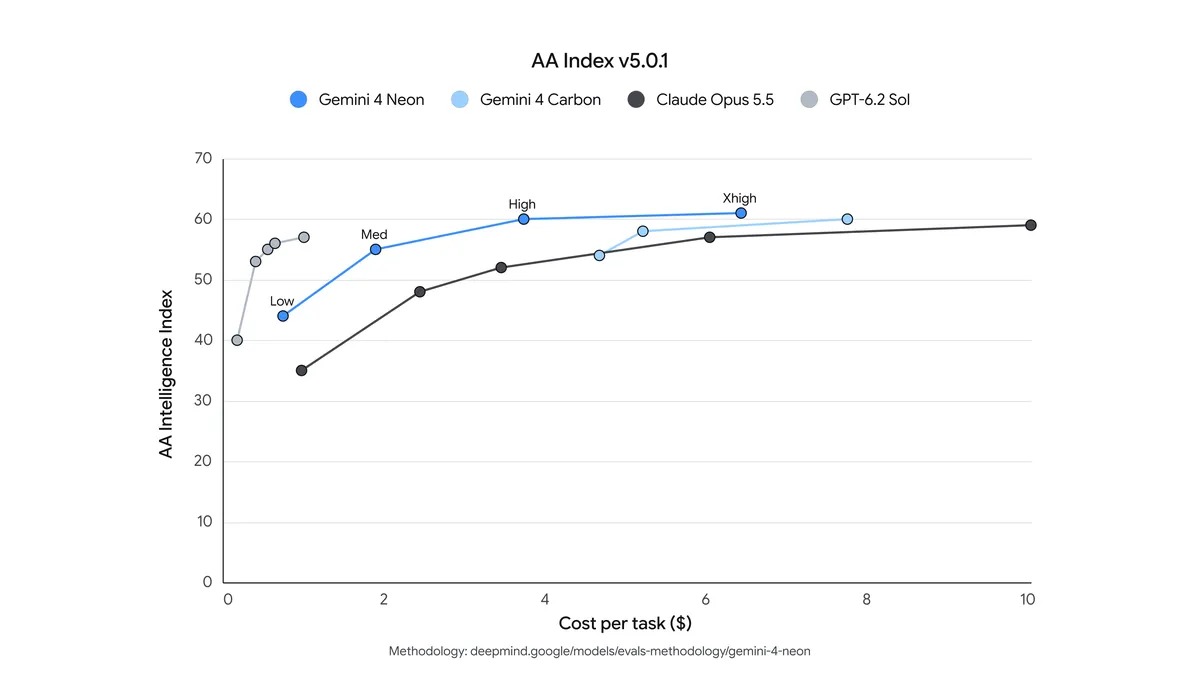
La ventana de contexto de un millón de tokens admite información procedente de hojas de cálculo, documentos PDF, gráficos, audio y video para trabajar con distintos formatos dentro de una misma tarea. En sus comparaciones de costos, Google indica que Neon configurado en high registra un costo por tarea un 32% inferior al de Carbon. El costo por tarea de Gemini 4 Neon en modo xhigh es al menos un 36% menor que el de Claude Opus 5.5 en su configuración máxima. En el gráfico, GPT-6.2 Sol registra un costo por tarea inferior al de Neon.
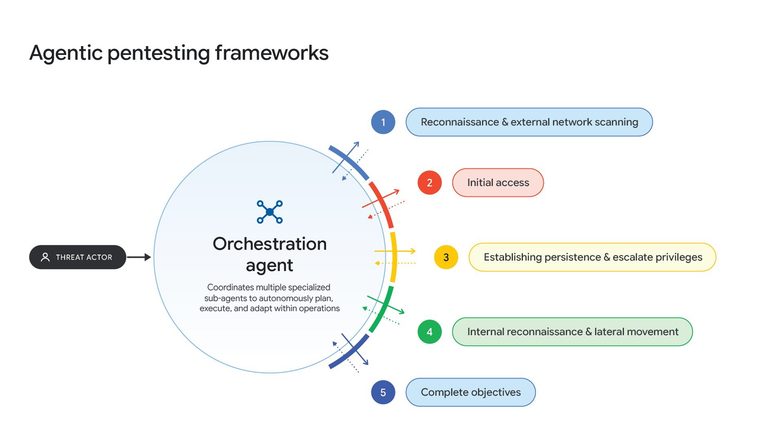
Las pruebas de ciberseguridad evalúan código seguro, explotación y corrección de vulnerabilidades
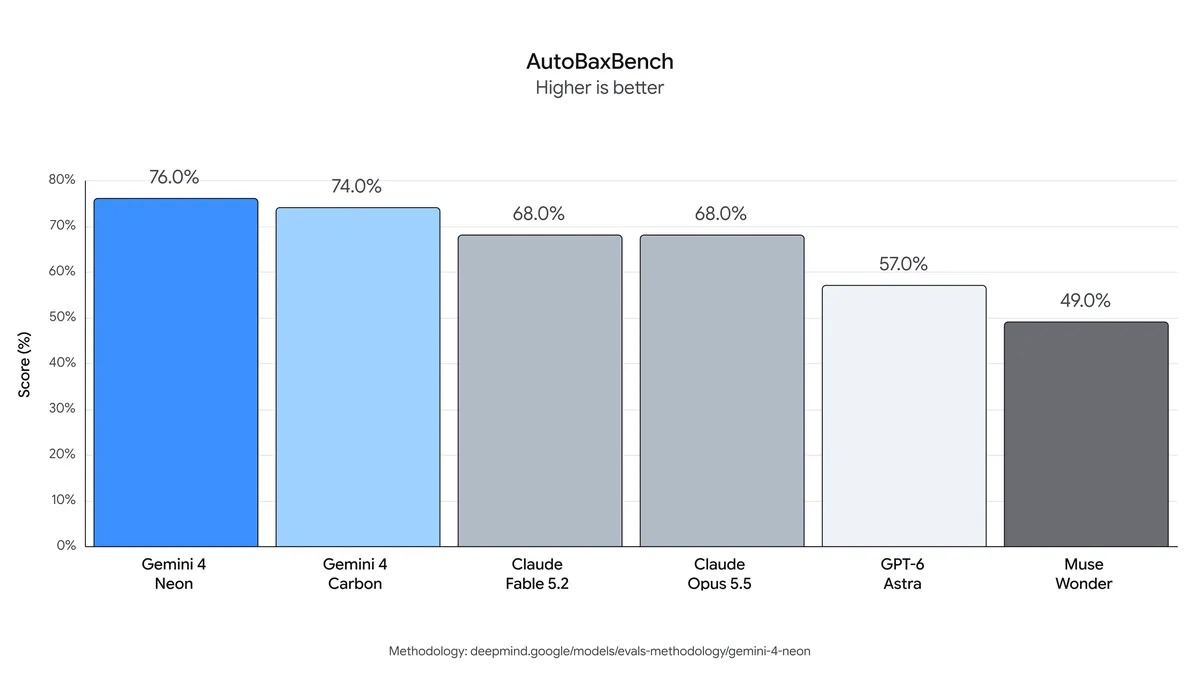
Gemini 4 Neon for cyber, la variante de Google para ciberseguridad, obtuvo un 76.0% en las tareas más difíciles de AutoBaxBench, una prueba que evalúa la generación de código seguro. En esas mismas tareas, Carbon registró un 74.0% y Claude Opus 5.5 obtuvo un 68.0%.
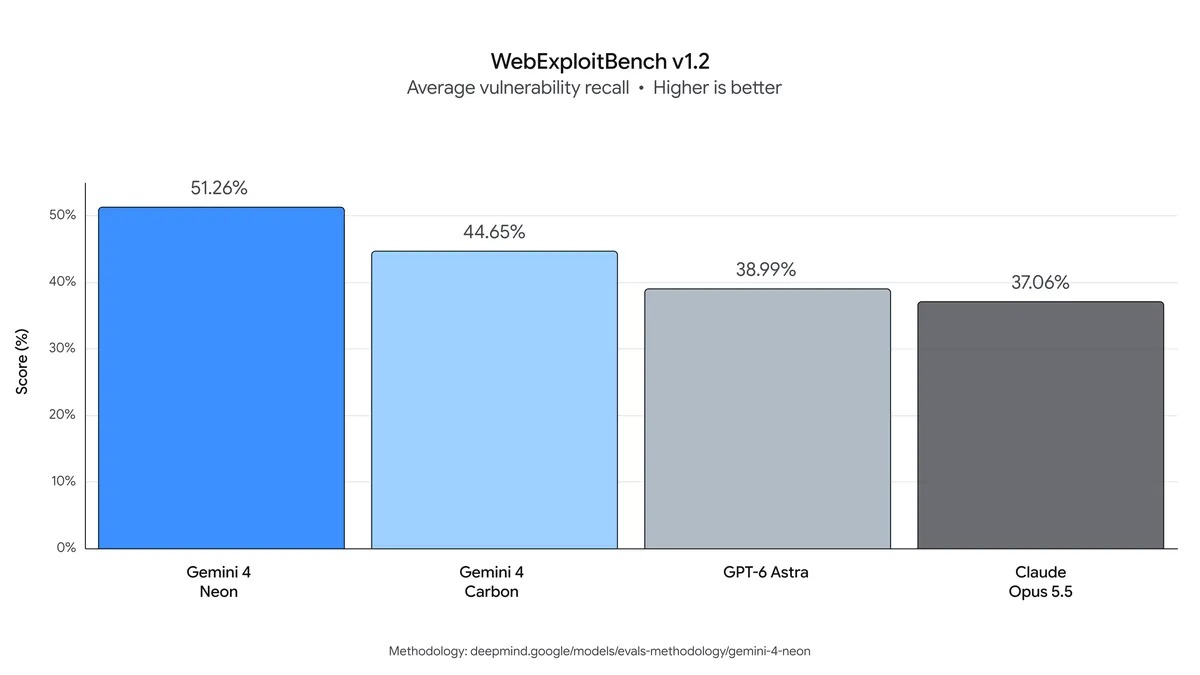
En WebExploitBench v1.2, utilizado para evaluar la capacidad de identificar y explotar vulnerabilidades en aplicaciones web, Neon registra un 51.26% de recuperación media de vulnerabilidades. El resultado supera el 44.65% de Carbon, el 38.99% de GPT-6 Astra y el 37.06% de Claude Opus 5.5.
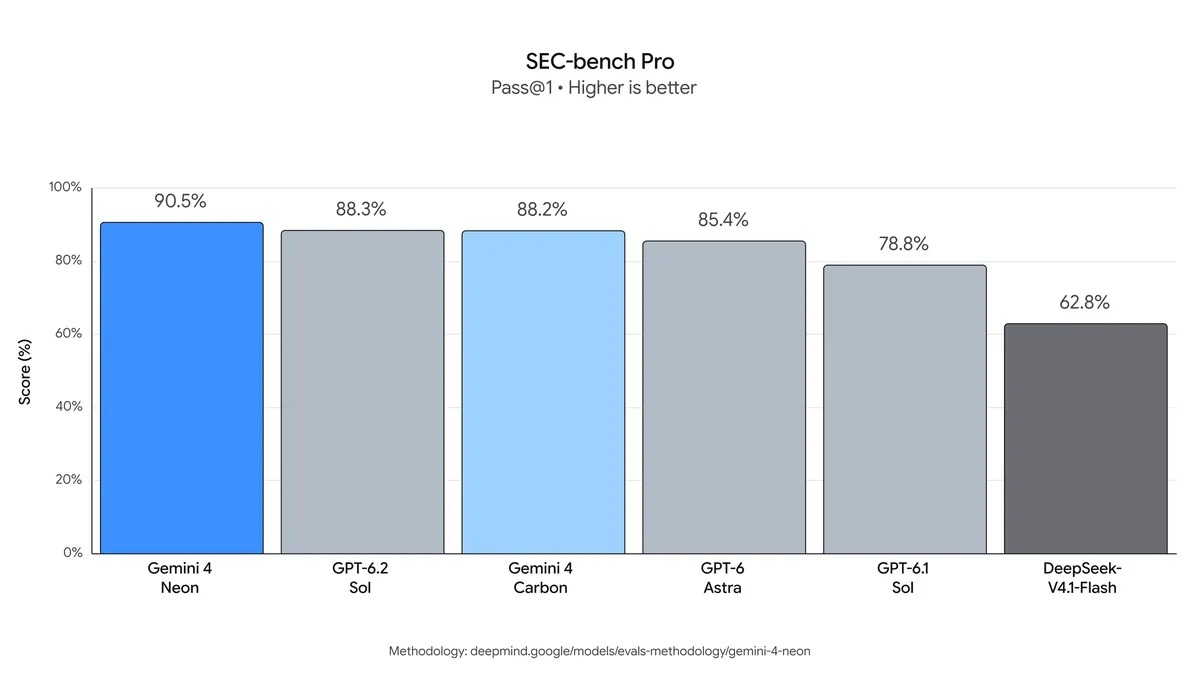
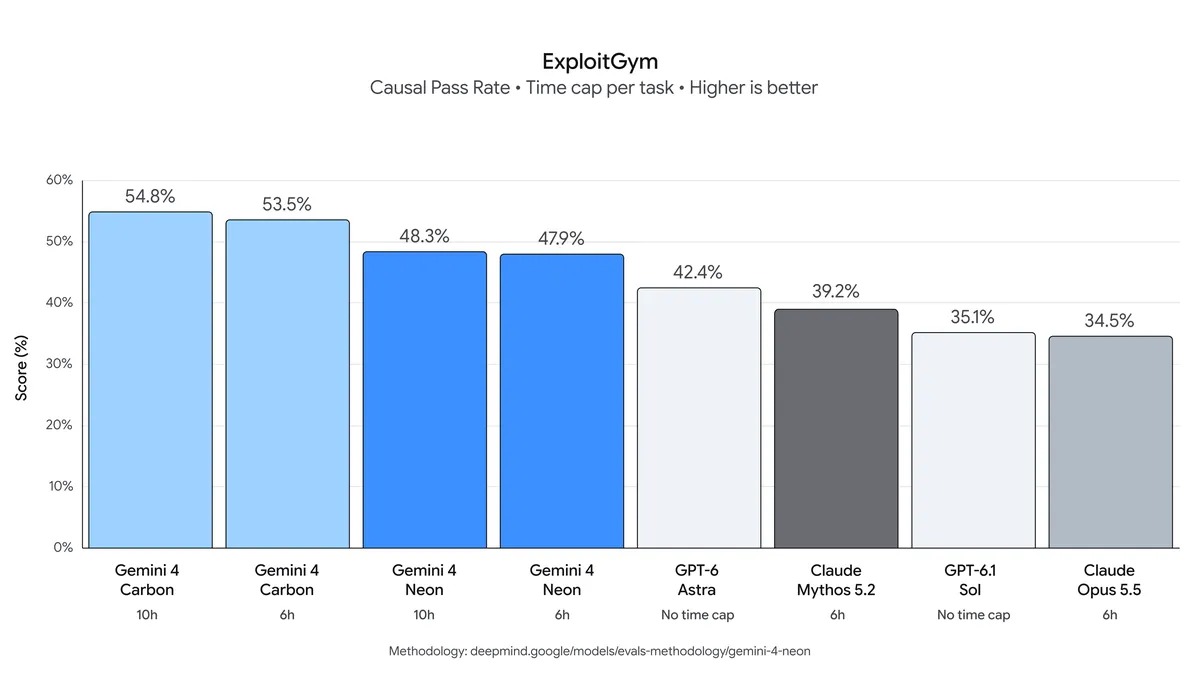
Para analizar código existente, Neon obtiene un 90.5% en SEC-bench Pro, una evaluación de detección de vulnerabilidades, frente al 88.3% de GPT-6.2 Sol y el 88.2% de Carbon. La empresa también evaluó la validación de fallas mediante ExploitGym, donde Neon alcanza un 48.3% con un límite de diez horas y un 47.9% con seis horas, resultados inferiores a los de Carbon en ambas condiciones.
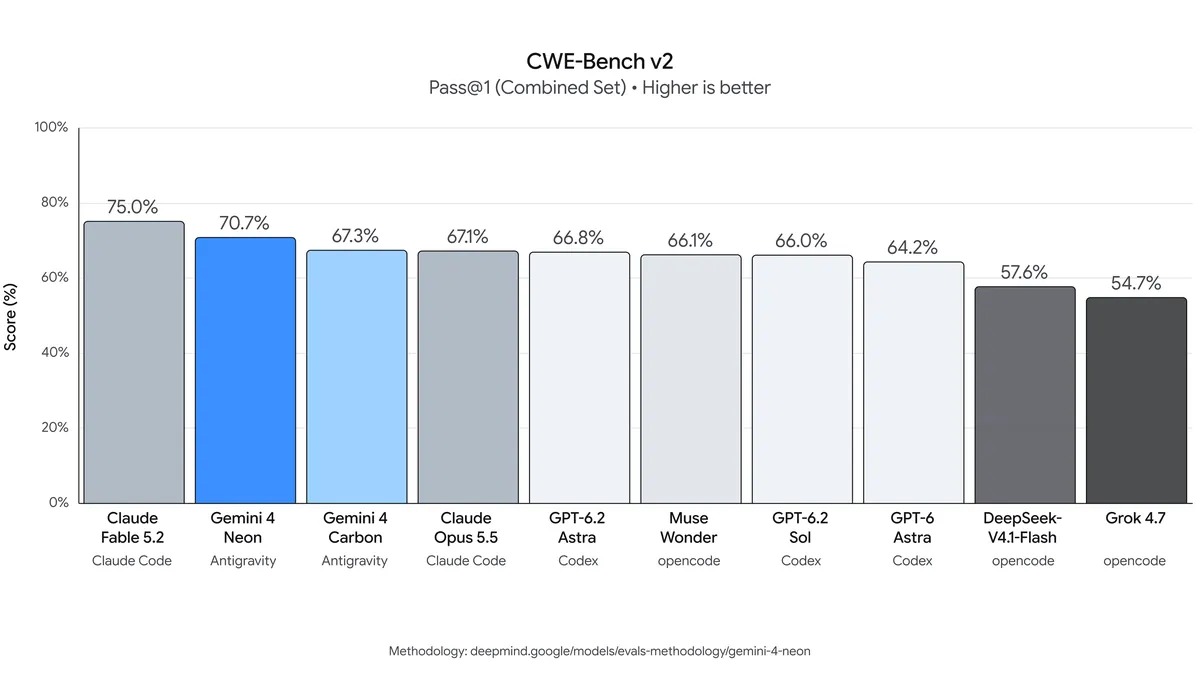
En la corrección de vulnerabilidades, CWE-bench v2 registra un 70.7% para Neon y un 67.3% para Carbon, equivalente a una diferencia de 3.4 puntos porcentuales. Claude Fable 5.2 obtiene un 75.0% y encabeza la comparación, por lo que Neon no presenta el mejor resultado de esta evaluación.
Inyección indirecta de instrucciones y evaluaciones internas de seguridad
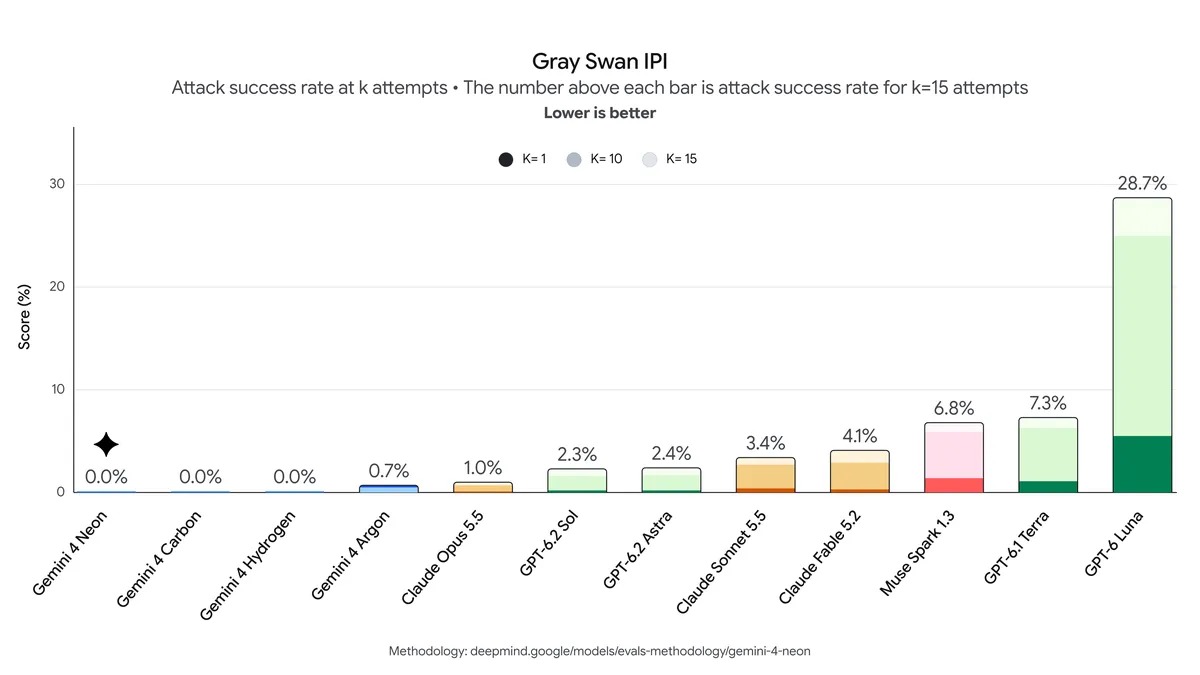
Google también evaluó la resistencia del modelo frente a ataques de inyección indirecta de instrucciones, que introducen órdenes maliciosas mediante páginas web, documentos, correos electrónicos o código. En Gray Swan IPI, Neon configurado con su máximo nivel de razonamiento y protecciones en tiempo real registra una tasa de éxito de ataques del 0%, resultado que también alcanzan Carbon e Hydrogen dentro de esta evaluación.
Las evaluaciones internas de seguridad de Google registran una tasa del 0.09% de acciones desalineadas y un 99.2% de aprobación en su prueba de honestidad de agentes. En otra medición interna destinada a detectar atajos indebidos durante tareas de programación, Neon obtiene un 2.45%, mientras que en Terminal-Bench 4.0 registra un 0.0% de trampas.
Gemini 4 Neon se incorpora a la familia junto con Carbon e Hydrogen
Google organiza la familia Gemini 4 en tres modelos con diferentes objetivos de procesamiento, costos y niveles de razonamiento, reservando Carbon para proyectos de larga duración y Hydrogen para tareas cotidianas que requieren menor tiempo de ejecución. Neon ocupa una posición intermedia en esta clasificación, aunque registra 61 puntos en Artificial Analysis frente a los 60 de Carbon y los 54 de Hydrogen.