OpenAI comenzó a aplicar textGrain en textos elegibles de ChatGPT y Codex para usuarios de la Unión Europea, una técnica que introduce una señal estadística invisible mediante la elección de palabras del modelo y que permitirá buscar posteriormente indicios de que el contenido fue generado por inteligencia artificial.
textGrain introduce una señal estadística en las palabras generadas
textGrain introduce una señal estadística mediante las palabras que selecciona el modelo durante la generación, sin agregar elementos visibles al texto. Un detector puede buscar posteriormente esa señal para determinar si el contenido presenta una marca de agua de OpenAI, aunque la compañía advierte que el resultado no es concluyente en todos los casos.
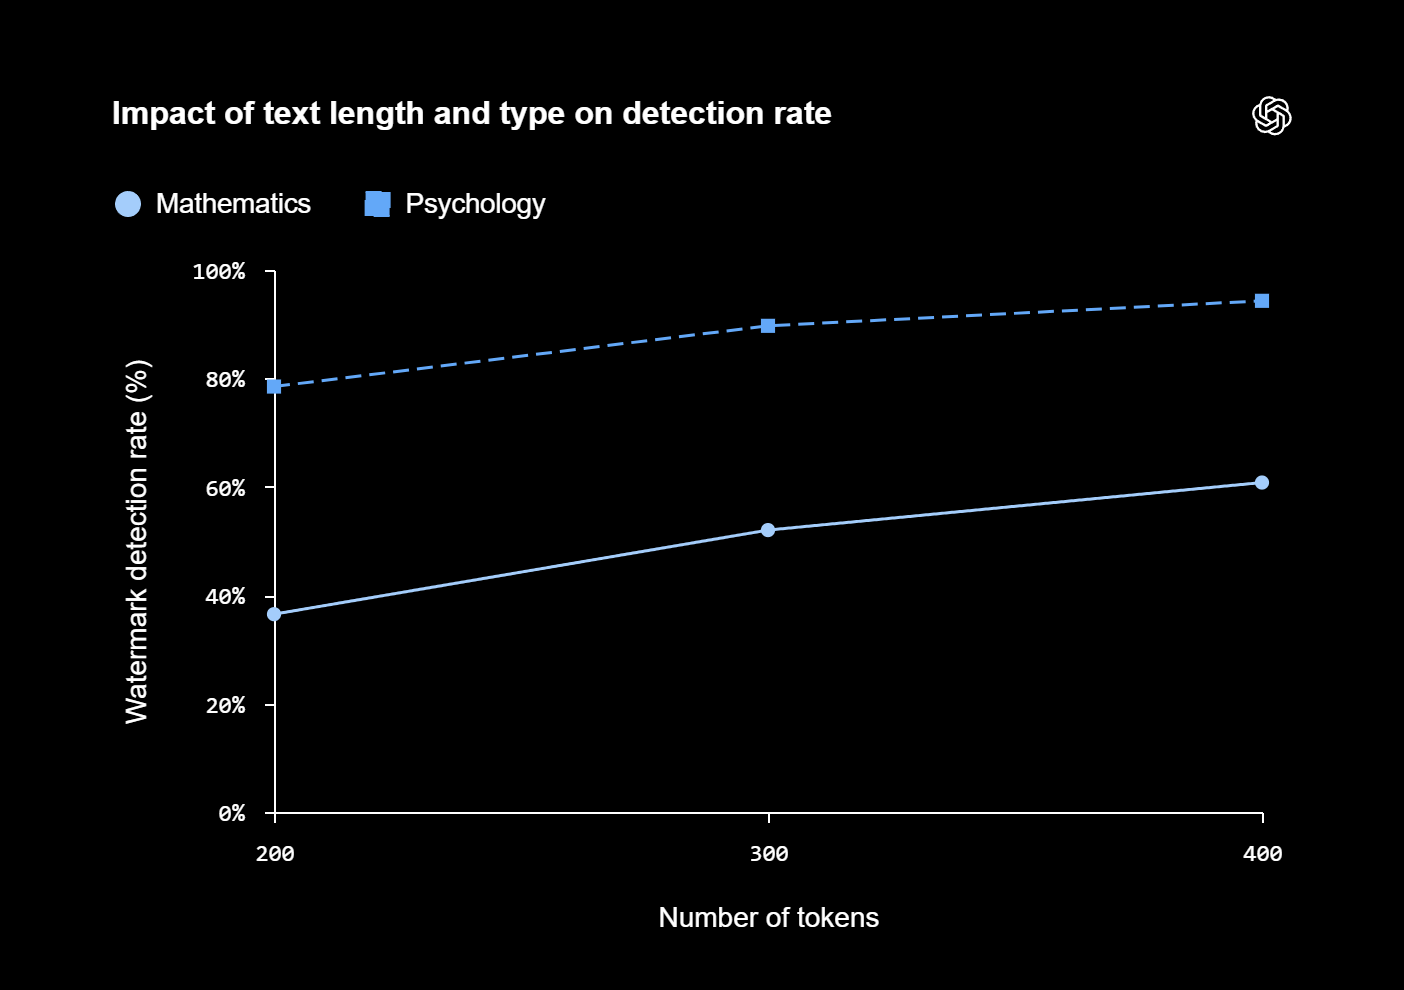
OpenAI utilizó respuestas en inglés del conjunto ELI5 sobre matemáticas y psicología, con una tasa objetivo de falsos positivos de 1%, y encontró que los textos más largos presentan mejores resultados.
En psicología, el detector identifica cerca del 80% de las marcas en textos de 200 tokens y alrededor del 95% cuando alcanzan los 400 tokens. En matemáticas la detección es menor, debido a una menor flexibilidad que existe al escoger palabras para expresar este tipo de contenidos.
Editar el texto puede reducir considerablemente la detección
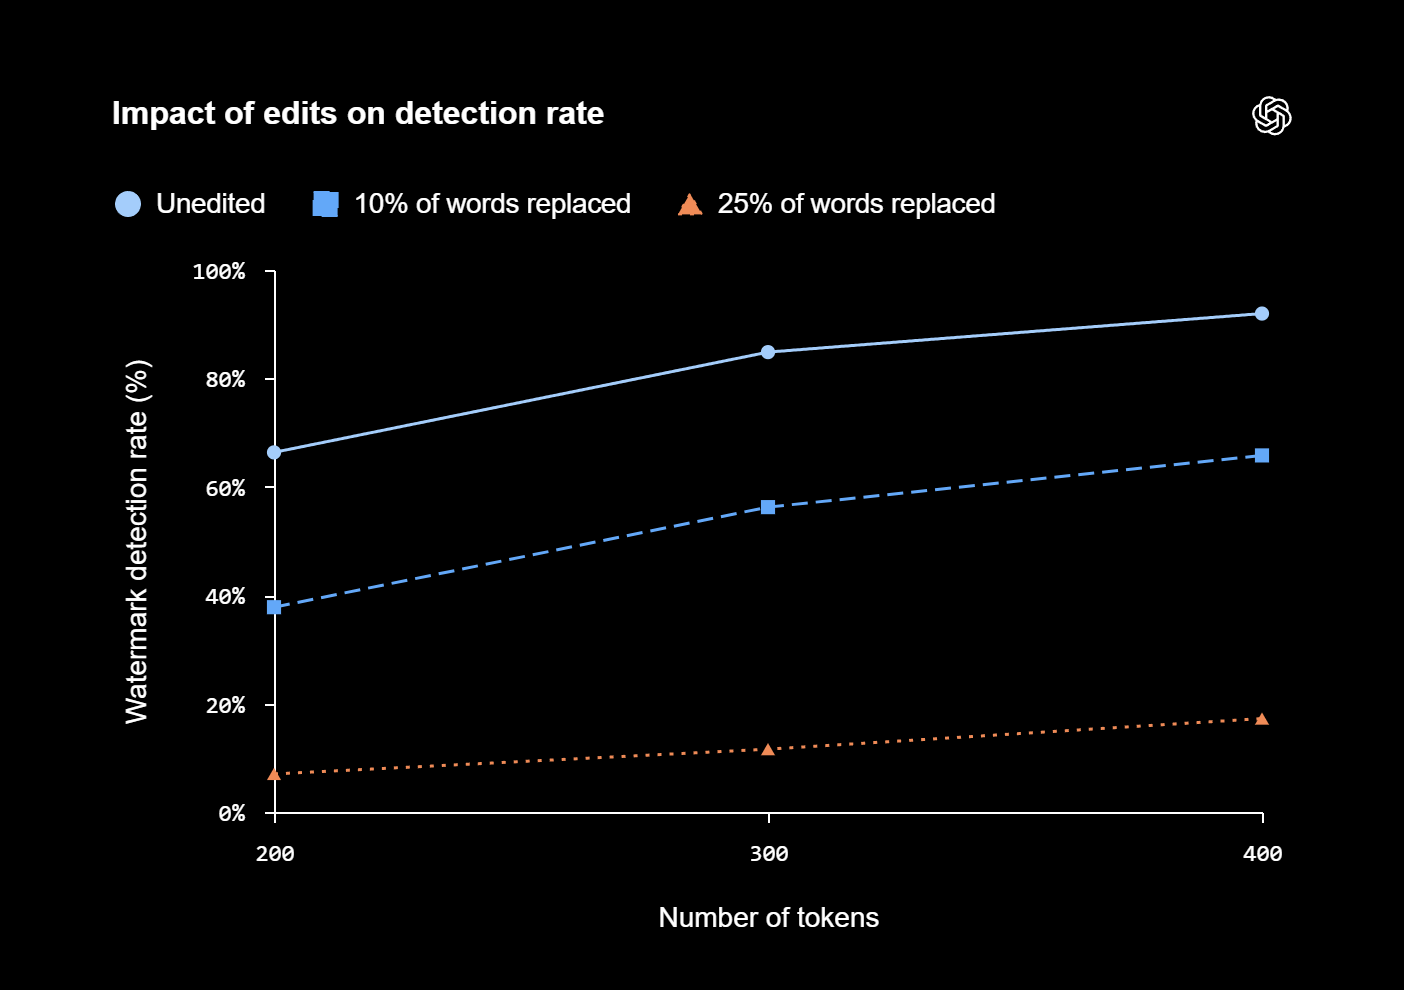
En textos de 400 tokens, la detección de textGrain cayó desde aproximadamente 92% hasta 66% al sustituir el 10% de las palabras por sinónimos y bajó a 17% cuando la modificación alcanzó el 25%, lo que muestra cuánto puede degradarse la señal con cambios relativamente acotados.
La misma tendencia aparece en respuestas de 200, 300 y 400 tokens, donde una mayor extensión mejora la detección inicial, pero esa ventaja disminuye a medida que aumenta la proporción de palabras reemplazadas y se vuelve especialmente débil cuando la edición alcanza una cuarta parte del contenido.